در مقالهای که برای کنفرانس ICRoM 2025 تهیه کردیم، ناوبری و حرکت ربات چهارپا را به دو سیاست یادگیری تقویتی تقسیم کردیم. سیاست سطح بالا فرمان حرکت بهسوی هدف و دورزدن موانع را تولید میکند؛ سیاست سطح پایین این فرمان را به حرکت پایدار روی زمین ناهموار تبدیل میکند. این صفحه خلاصه پژوهش، پنج شکل اصلی و نتایج گزارششده در مقاله را در دسترس قرار میدهد.
متن کامل مقاله (PDF انگلیسی · ۶ صفحه)
نویسندگان: یوسف ایوبیراد، سید مهدی سرفرازی و محمد شهبازی.
وابستگی سازمانی: آزمایشگاه هوش مصنوعی و سیستمهای دینامیکی، دانشکده مهندسی مکانیک، دانشگاه علم و صنعت ایران.
کنفرانس: سیزدهمین کنفرانس بینالمللی رباتیک و مکاترونیک، ICRoM 2025؛ ۱۶ تا ۱۸ دسامبر ۲۰۲۵، تهران.
فایل PDF، نسخه مقاله کنفرانسی ارائهشده توسط نویسندگان است. تمام نتایج این صفحه از شبیهسازی به دست آمدهاند و شامل آزمایش روی ربات واقعی نیستند.
چکیده پژوهش
رباتهای چهارپا برای کاربردهایی مانند امداد و اکتشاف، باید هم در محیطهای دارای مانع مسیر مناسب پیدا کنند و هم روی پله، شیب و زمین ناهموار تعادل خود را حفظ کنند. چارچوب پیشنهادی، این دو مسئله را با یک رابط فرمان سرعت از هم جدا میکند. سیاست ناوبری، فرمان سرعت خطی و زاویهای را در دستگاه مختصات بدنه تولید میکند. سیاست حرکت، با استفاده از اطلاعات وضعیت بدنه و مفاصل و نمونهبرداری محلی از ارتفاع زمین، هدفهای مفصلی را میسازد که کنترلکننده PD دنبال میکند.
این ساختار امکان آموزش و اصلاح مستقل هر لایه را فراهم میکند و تداخل هدفهای پاداش ناوبری و حفظ تعادل را کاهش میدهد. ارزیابی در Isaac Gym شامل نقشههای دارای مانع، زمینهای مختلف و اجرای همزمان دو لایه است. نتایج گزارششده نشان میدهند که این تفکیک، در شرایط شبیهسازی مقاله، موفقیت ناوبری و پایداری حرکت را نسبت به روش یکپارچه بهبود میدهد.
معماری دو لایه
سیاست سطح بالا از وضعیت و جهت ربات، موقعیت نسبی هدف و اطلاعات موانع استفاده میکند. خروجی آن یک فرمان سرعت محدودشده است. سیاست سطح پایین این فرمان را همراه با وضعیت بدنه و مفاصل و ۱۸۷ نمونه ارتفاع محلی زمین دریافت میکند و هدفهای مفصلی را میسازد. محدودسازی و هموارسازی فرمانها، ارتباط دو لایه را با محدوده حرکتی تعریفشده در شبیهسازی سازگار میکند.
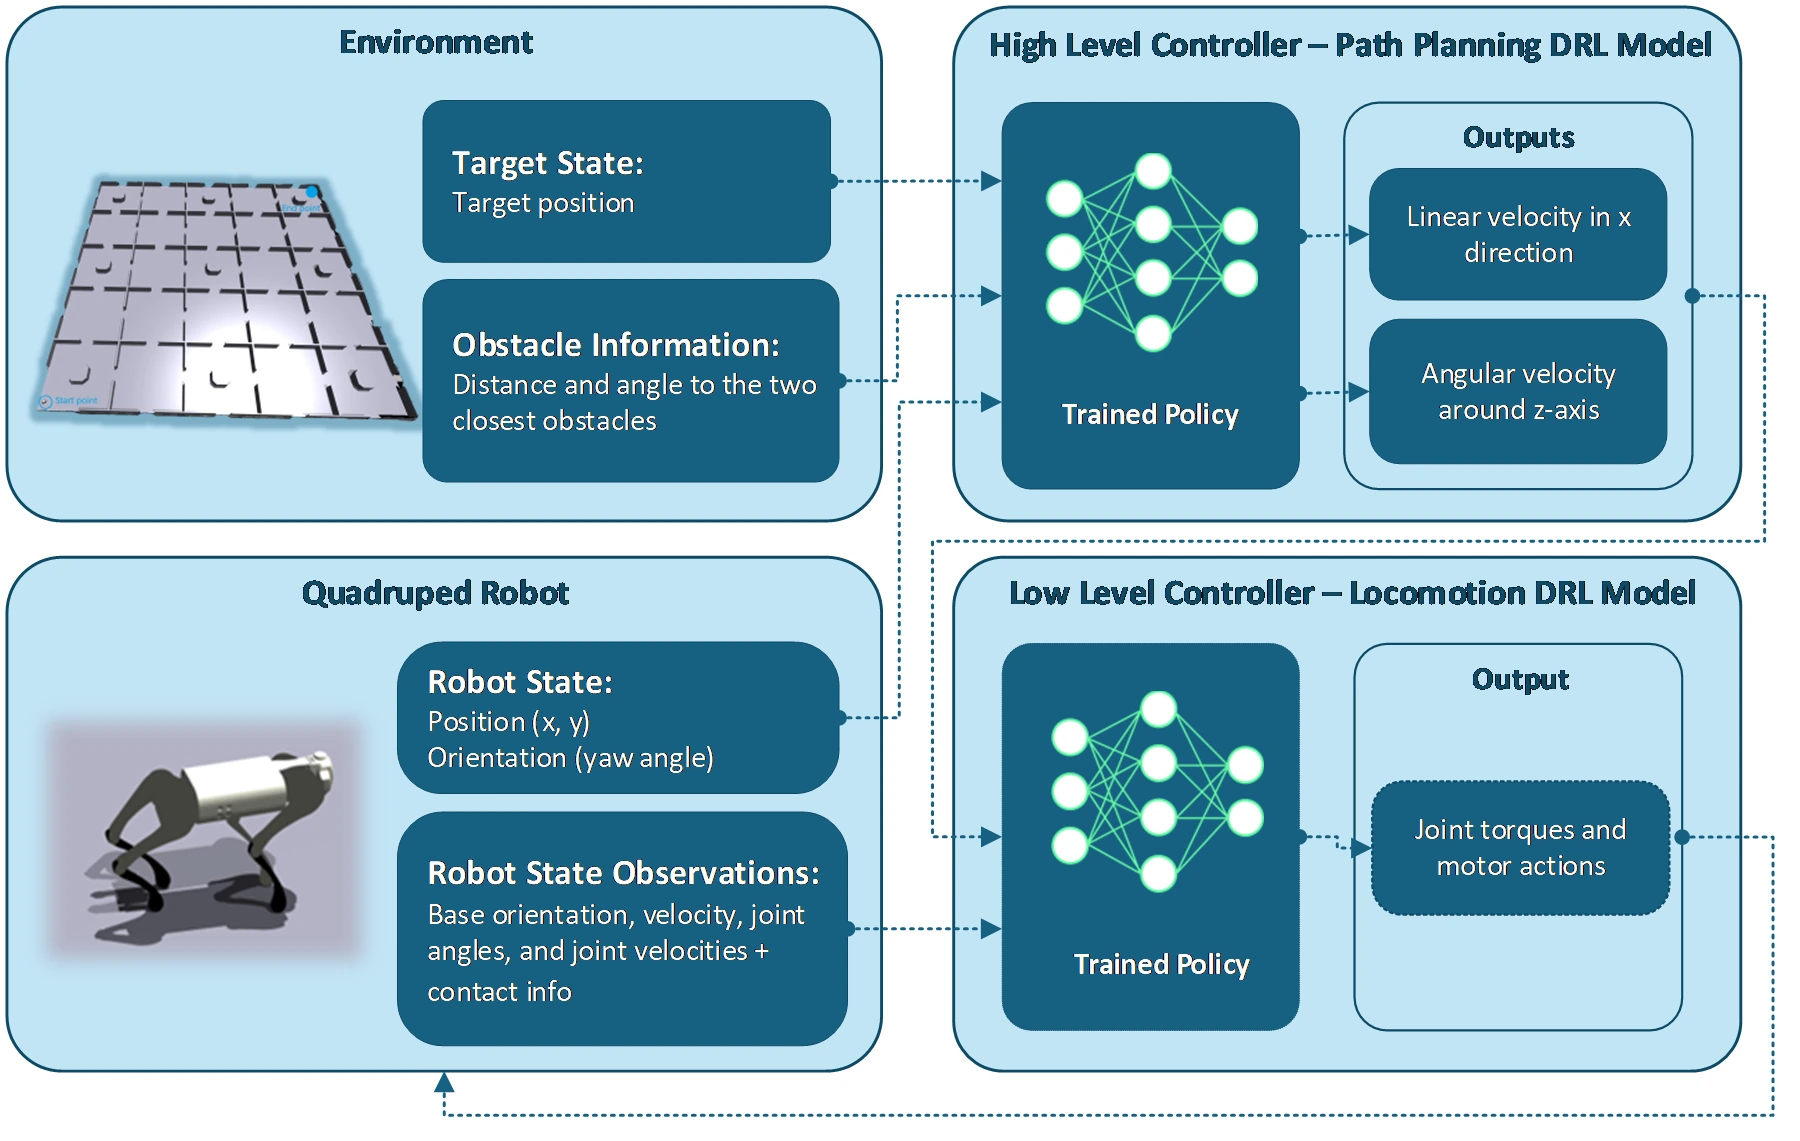
شکل ۲ مقاله. سیاست برنامهریزی مسیر و سیاست حرکت از طریق یک رابط فرمان سرعت به هم متصلاند.
شبیهسازی و شناخت محلی زمین
آزمایشها در Isaac Gym و با ساختاری مشابه Legged Gym انجام شدهاند. زمینهای آزمایش شامل پله، شیب، موانع مجزا و سطوح سینوسیاند. آموزش ناوبری در محیطی به ابعاد ۱۰ × ۱۰ متر با موانع تولیدشده بهصورت رویهای انجام میشود و نقشههای بزرگتر به دامنه آموزش نگاشت میشوند.
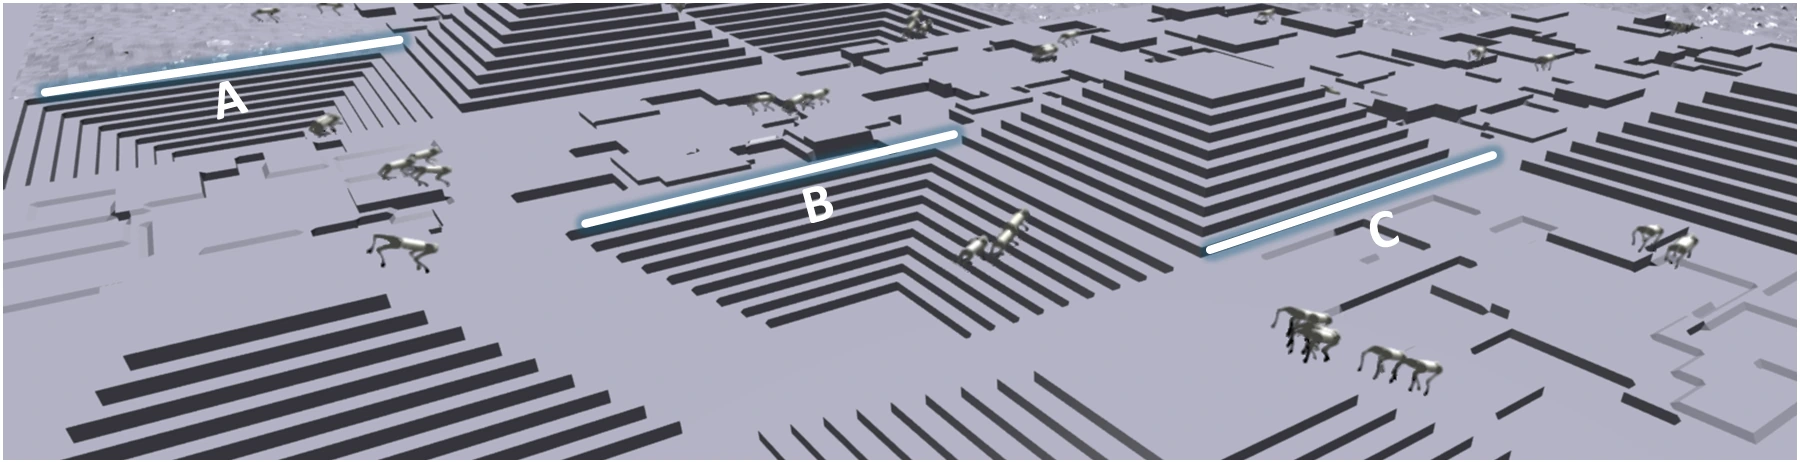
شکل ۱ مقاله. زمینهای شبیهسازی: A، موجهای سینوسی؛ B، موانع مجزا؛ C، پلههای هرمی.
برنامهریز سطح بالا با الگوریتم PPO و یک شبکه با دو لایه پنهان ۲۵۶ نورونی آموزش داده شده است. ابتدا سیاست حرکت روی زمینهای مختلف آموزش میبیند؛ سپس با ثابت نگهداشتن آن، سیاست ناوبری آموزش داده میشود. مقاله حدود پنج ساعت آموزش مجموع دو سیاست را روی کارت NVIDIA RTX 3080 Ti و با حدود ۱۲ هزار محیط شبیهسازی موازی گزارش میکند.
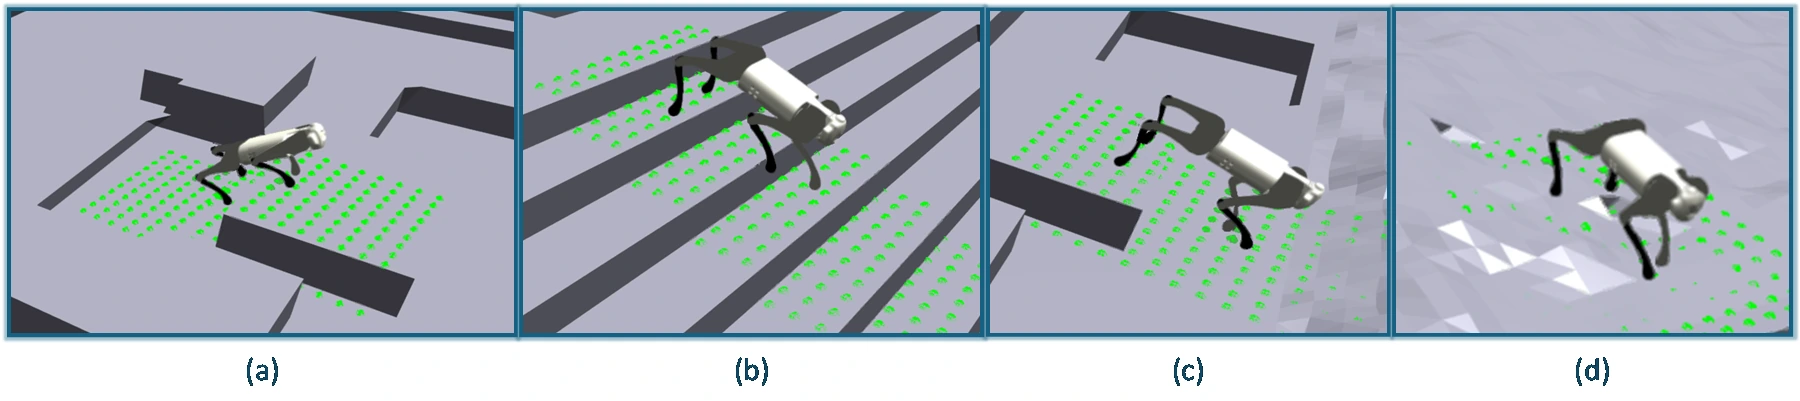
شکل ۳ مقاله. عبور از زمینهای مختلف: (a) بالارفتن از مانع، (b) پله، (c) پایینآمدن از مانع و (d) سطح سینوسی. نقاط سبز نمونهبرداری محلی زمین را نشان میدهند.
از نقشه تا فرمان حرکت
نقشه اشغال ورودی به ویژگیهای موانع تبدیل میشود تا سیاست ناوبری بتواند مسیر حرکت بهسوی هدف را تعیین کند. برنامهریز فرمان سرعت میدهد و سیاست حرکت، تعادل و تماس پاها با زمین را در شبیهسازی فیزیکی مدیریت میکند.
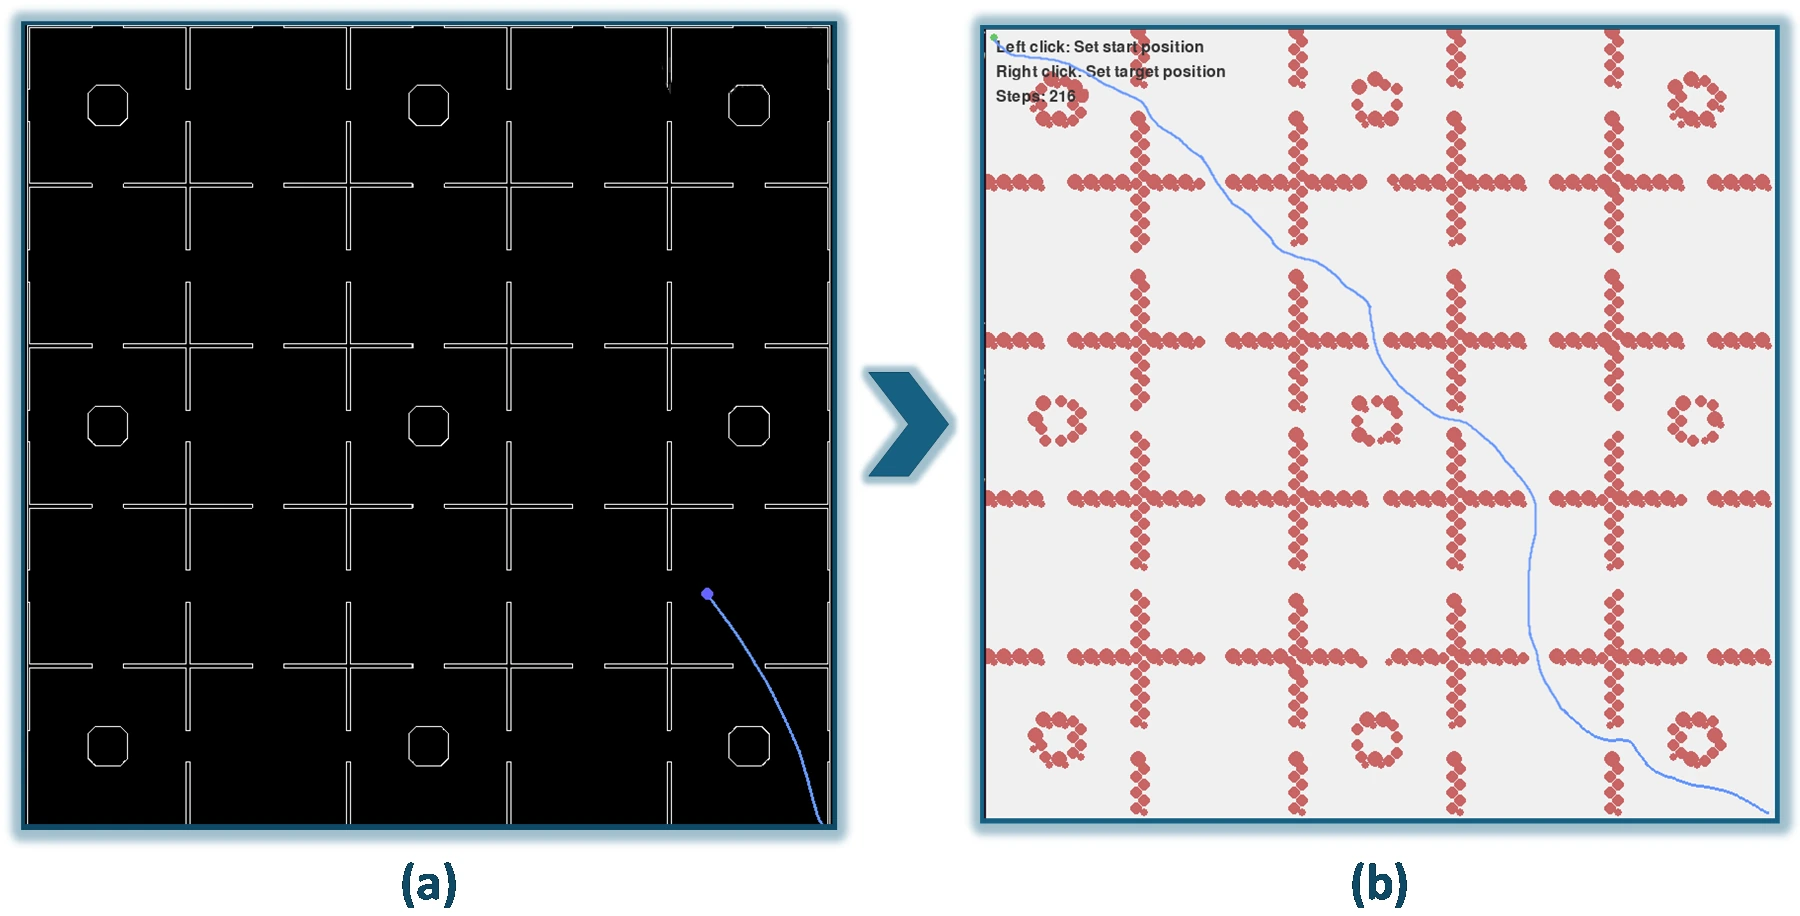
شکل ۴ مقاله. (a) نقشه اشغال ورودی؛ (b) نمایش دایرهای موانع و مسیر ناوبری.
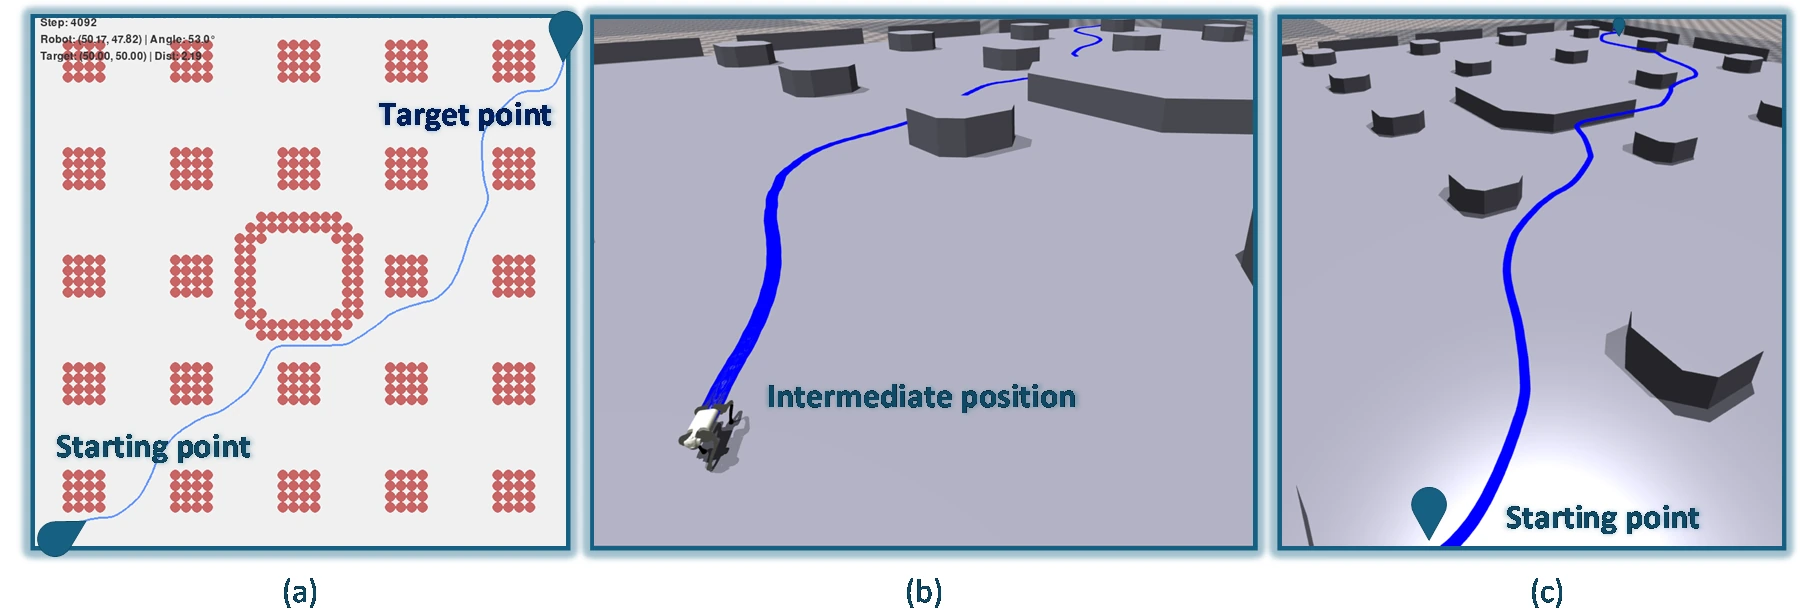
شکل ۵ مقاله. (a) نقشه موانع و مسیر، (b) موقعیت میانی ربات و (c) مسیر کامل در محیط شبیهسازی.
نتایج گزارششده
جدول زیر مقادیر جدول اول مقاله را بازنویسی میکند. موفقیت ناوبری، تعداد برخورد، نسبت طول مسیر و خطای دنبالکردن سرعت، معیارهای جداگانهاند. نرخ موفقیت ناوبری بهتنهایی عملکرد کامل سامانه روی زمین ناهموار را توصیف نمیکند.
| روش | موفقیت ناوبری | برخورد در هر اپیزود | نسبت طول مسیر | خطای دنبالکردن سرعت (متر بر ثانیه) |
|---|---|---|---|---|
| چارچوب سلسلهمراتبی | ۹۴٫۲٪ | ۰٫۰۸ | ۱٫۰۸۳ | ۰٫۰۴۲ |
| روش یکپارچه مبنا | ۸۱٫۷٪ | ۰٫۲۸ | ۱٫۱۹۴ | ۰٫۰۶۱ |
| آزمایش حذف ساختار سلسلهمراتبی | ۸۳٫۵٪ | ۰٫۲۲ | ۱٫۱۷۶ | ۰٫۰۵۷ |
| آزمایش حذف حسکردن زمین | ۹۱٫۸٪ | ۰٫۱۱ | ۱٫۰۹۱ | ۰٫۰۶۹ |
مقاله همچنین ۸۸٫۶٪ موفقیت ناوبری روی نقشههای دیدهنشده بدون آموزش مجدد و ۸۷٫۴٪ موفقیت اجرای کامل در محیطهای دارای مانع و تغییرات ارتفاع را گزارش میکند. تعداد برخورد در هر اپیزود از ۰٫۲۸ در روش یکپارچه به ۰٫۰۸ میرسد؛ یعنی ۷۱٫۴٪ کاهش. با حذف اطلاعات ارتفاع زمین، نرخ افتادن گزارششده از ۱٫۴٪ به ۷٫۳٪ افزایش پیدا میکند.
محدوده و محدودیتها
ارزیابی مقاله در شبیهسازی، با موانع ثابت و شرایط حسکردن اسمی انجام شده است. نمایش محلی ارتفاع زمین، اطلاعات معنایی یا ساختار دوردست مسیر را در اختیار ربات نمیگذارد. پیچهای تنگ و توالی سکوهای کوچک میتوانند پیشروی را کند کنند. ثابت نگهداشتن سیاست حرکت هنگام آموزش ناوبری نیز سازگاری مشترک دو لایه را محدود میکند.
نقشهسازی آنلاین، موانع متحرک، آموزش مشترک انتخابی و اعتبارسنجی روی سختافزار، مسیرهای ادامه پژوهشاند. نتایج شبیهسازی این مقاله، اثبات قابلیت اطمینان روی ربات واقعی نیستند.
توضیح سهم من در این پژوهش و ادامه کار در پایاننامه در صفحه معرفی پژوهش، به زبان انگلیسی آمده است.
متن کامل و ارجاع
دانلود متن کامل مقاله کنفرانسی (PDF انگلیسی).
Y. Ayoubi Rad, S. M. Sarfarazi and M. Shahbazi, “Hierarchical Deep Reinforcement Learning for Quadruped Navigation over Complex Terrains,” 13th RSI International Conference on Robotics and Mechatronics (ICRoM 2025), Tehran, Iran, December 16–18, 2025.
هر پنج شکل این صفحه از فایل Word مقاله استخراج شدهاند. معادلات، منابع و بحث کامل در فایل PDF موجودند.